Desarrollan un sistema informático que permite predecir qué ventas tendrá un libro si se publica
Fuente: Universidad de Granada
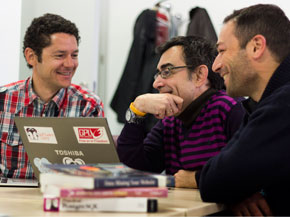
En la foto, de izquierda a derecha, los investigadores de la Universidad de Granada Pedro Ángel Castillo Valdivieso, Juan Julián Merelo Guervós y Antonio Miguel Mora García. (FOTO: UGRDIVULGA)
Investigadores granadinos han desarrollado un nuevo sistema informático que permite predecir qué ventas tendrá un libro si se llega a publicar, una información muy útil para las editoriales, que podrían ajustar así la tirada del mismo. Esta nueva herramienta, denominada PreTEL, se basa en redes neuronales artificiales, y permite también realizar simulaciones de lanzamientos y tiradas desde un punto de vista estadístico, con lo que puede ayudar a decidir si un libro es publicable o no.
Este proyecto ha sido desarrollado por los investigadores Pedro Ángel Castillo Valdivieso, Juan Julián Merelo Guervós y Antonio Miguel Mora García, pertenecientes al grupo de investigación GeNeura de la Universidad de Granada, junto con la empresa granadina PRM Consultores S.C.A., que llevará a cabo la explotación de los resultados del mismo.
Como explica el profesor Castillo Valdivieso, “este sistema se entrena previamente, considerando datos de miles de libros ya publicados y obteniendo de este modo un modelo matemático que sea capaz de realizar estimaciones con una determinada probabilidad”. Para ello, se parte de una base de conocimiento de tirada editorial en constante actualización y ampliación. PreTEL funciona generando un modelo de estimación de datos que, una vez entrenado, es capaz de interpretar los valores de un nuevo libro para ofrecer datos de la estimación de tirada y venta.
Inteligencia artificial
 La generación de estos modelos se puede basar en diferentes métodos, siendo los más utilizados en la actualidad las redes neuronales artificiales, los modelos de regresión logística, los árboles de decisión, y los modelos tipo ARIMA. “Todos estos métodos basados en la inteligencia artificial tienen la capacidad de aprender y adaptarse, de tal forma que si en el futuro se dispone de nuevos datos, se podrán re-entrenar para corregirse y mejorar los resultados de predicción”, apunta el investigador.
De este modo, cuanto mayor sea la base de conocimiento en lo referente al número de libros contenidos, mejor se espera que sea el modelo que realice la predicción, y mayor la calidad de las estimaciones.
Por último, puesto que existen otras variables externas que no suelen ser almacenadas o medidas durante el proceso de venta (tales como la coyuntura económica, modas literarias, interés de temática no ficción, renombre del autor, etc.), y no forman parte de la base de conocimiento, se utilizan para ponderar los resultados de estimación obtenidos del modelo predictivo a modo de valoración del usuario.
Últimas publicaciones
Un equipo de la Universidad de Sevilla, liderado por el profesor del Departamento de Expresión Gráfica e Ingeniería en Edificación Juan José Moyano, ha desarrollado un método computacional para reconstruir digitalmente la geometría de antiguas construcciones a partir de los restos arqueológicos que han llegado hasta nuestros días.
Sigue leyendo
La obesidad y los trastornos metabólicos constituyen uno de los principales retos de salud pública a nivel mundial. Aunque se sabe que el cerebro desempeña un papel fundamental en la regulación del apetito y del consumo energético, muchos de los mecanismos que permiten integrar las señales procedentes del resto del organismo siguen siendo poco conocidos.
Sigue leyendo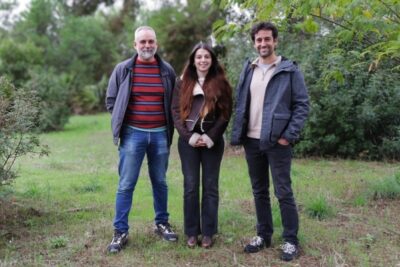
Un estudio realizado por los departamentos de Ingeniería Forestal y Botánica, Ecología y Fisiología Vegetal de la Universidad de Córdoba revela que la presencia de las plantas invasoras en Sierra Nevada y Sierra de los Filabres, dos ecosistemas montañosos de Andalucía especialmente vulnerables al cambio climático y caracterizados por albergar plantas únicas, es actualmente bajo.
Sigue leyendo